关于 AI 时代的一份思考笔记:文明质变的开关,不在技术占比,而在信任还站不站得住。
有一件事,我们可能做得太久了,久到已经察觉不到它在变。
从前遇到困惑,我们的第一反应是请教真人。为什么是真人?因为一个真人背后,站着四样东西:师承、专业共同体、声誉,以及制度。他答错,你可以追问;他答对了,你心里踏实,因为这份笃定是有来处的。
现在我们直接问 AI。反馈确实极快,结果似乎更专业。
于是,权威从“人”转移到了“系统输出”。对人的信任,转移成了对 AI 系统的信任。
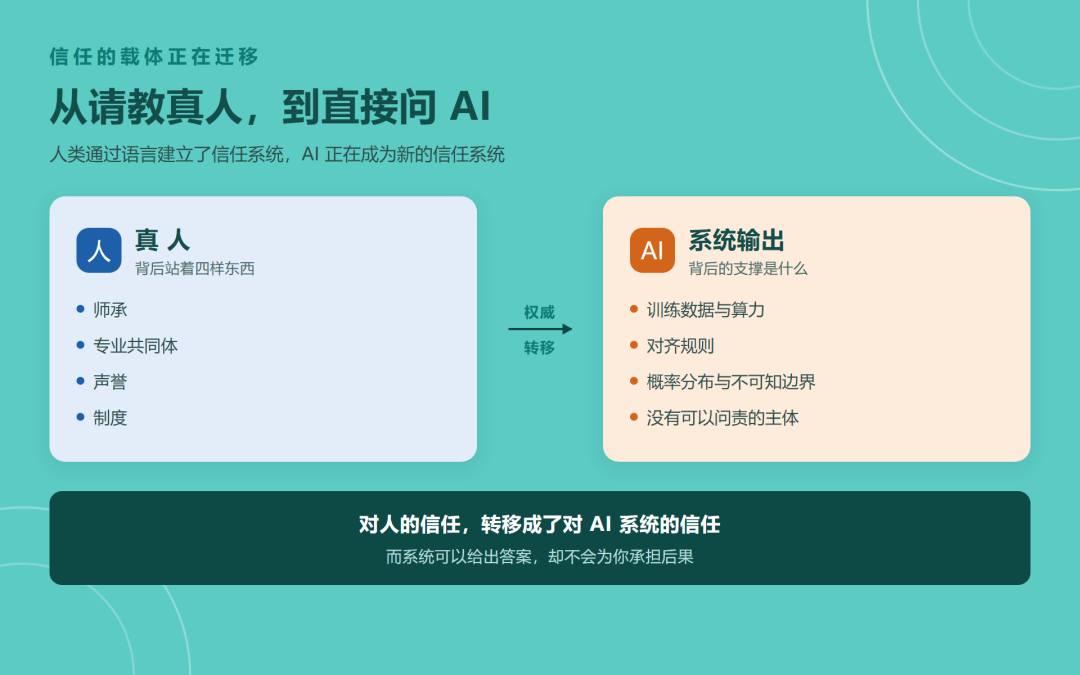
信任的载体正在迁移:从请教真人,到直接问 AI
一、语言是人类的第一套信任系统
这件事之所以值得停下来想一想,是因为语言本身就是一套精心设计的信任技术。
人类通过语言建立了信任系统,从而实现了大规模合作。
演化生物学家罗宾·邓巴算过一笔账:以人类新皮层的体积,能维持的熟人关系上限大约在 150 人左右。这就是“邓巴数”。要突破这个天花板,只有一个办法:把梳毛的时间省下来。邓巴在《梳毛、八卦及语言的进化》中提出的正是这个解释:语言是人类为节省社交成本而演化出来的“廉价替代”。灵长类动物靠互相梳毛维持关系,人类改用八卦和语言。
语言带来的不只是沟通效率,而是信任半径的扩张。历史学家尤瓦尔·赫拉利在《人类简史》里把这件事推到了极致:人类之所以能统治世界,是因为能“一起”想象虚构的故事,国家、货币、法律、人权,都不在宇宙里,只在共同想象中;正是它们,让互不相识的陌生人可以合作。
他有一句判断说得极准:金钱是有史以来最普遍也最有效的互信系统。
从语言到货币,人类每一次协作规模的跃迁,背后都对应着一套新的信任装置。
而现在,AI 正在成为新的信任系统。它接管了“我向谁咨询、我相信谁判断”这个原本由人担任的位置。
二、我原来想错了:不是“占比”,是“失灵”
坦白讲,我一开始想的不是这样。
我曾经以为:
(1)技术在思考中的占比超过了某个比例,人就带来阶层的跃迁,例如从干事变领导,从打工人变 CEO;
(2)技术在思考中的占比超过了某个比例,人类带来文明的质变,例如梦想可以成真,会做梦的人成为梦想家。
这其实是一个顺理成章的猜想。AI 越强,人越强;人越强,文明越进。似乎只要盯住“占比”这一个变量就够了。
但在与 DeepSeek 反复讨论之后,我看清了一件事:问题的关键不在“技术在思考中的占比”,而在三个失灵。不是用得多或少的问题,而是这套新信任系统在三个方向上同时松动。
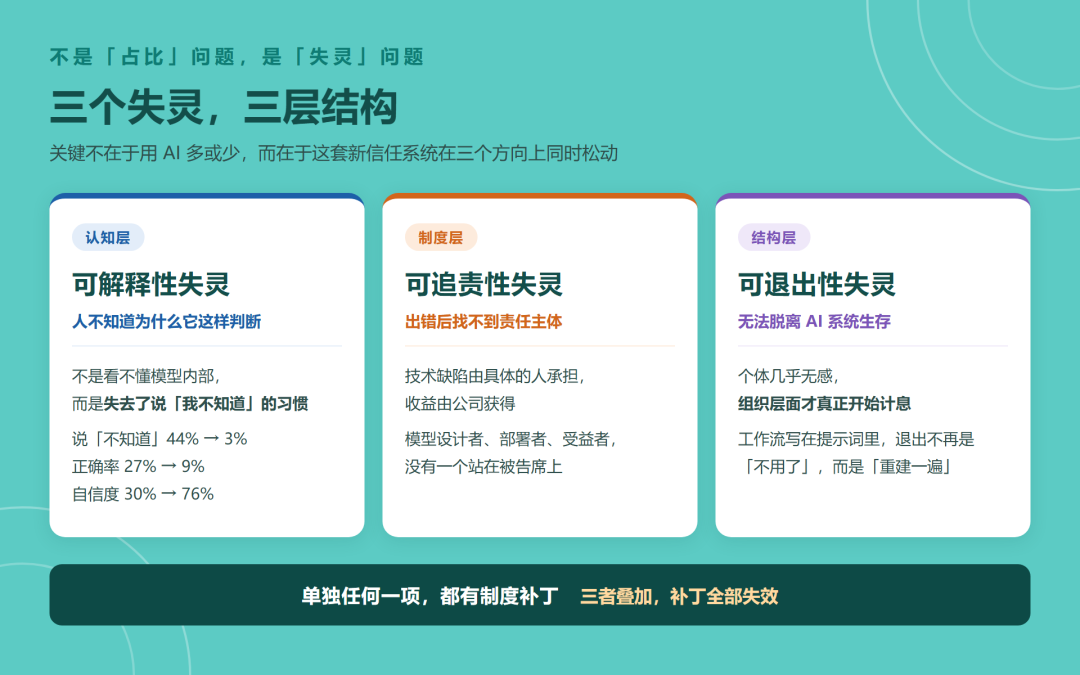
不是「占比」问题,是「失灵」问题:三个失灵,三层结构
三、三个失灵
1. 可解释性失灵:人不知道为什么 AI 系统这样判断
第一个失灵在认知层:输出的结论摆在面前,我们却说不出它凭什么这么说。
这不只是“看不懂模型内部”的技术问题。可解释性失灵的真实代价:不是我们看不懂了什么,而是我们失去了说“我不知道”的习惯。
2026 年 7 月,米兰比可卡大学 Valerio Capraro 等人在 arXiv 上发布的研究(5 个实验、3132 名参与者)测量了一个更贴近日常的指标:人还会不会说“我不知道”。题目被刻意设计成大模型容易答错,比如电影里的视觉细节。结果是:没有 AI 时,44% 的人坦然承认不知道,正确率 27%,自信度 30%;有 AI 在旁,说“不知道”的比例从 44% 骤降到 3%,正确率跌到 9%,自信度却升到 76%。
翻译成大白话:AI 没有让我们更聪明,它让我们更敢答。
不知道自己不知道的那部分人并没有消失,只是变成了“在 AI 加持下不懂装懂”的那部分人。
2. 可追责性失灵:出错后找不到责任主体
第二个失灵在制度层:一旦出错,找不到该负责的人。
2018 年 3 月 18 日夜里,美国亚利桑那州坦佩市,Uber 的一辆自动驾驶测试车把一位推自行车过马路的 49 岁女性撞死了。这是全球第一例自动驾驶汽车致人死亡事故。
美国国家运输安全委员会的调查还原了完整的链条:车载雷达在碰撞前约 6 秒就观测到了这位行人,但软件反复把她误识别为不明物体、车辆、自行车,直到碰撞前 1.3 秒才判断需要紧急制动;而 Uber 设定的系统无法自动启动紧急刹车,必须由安全员手动操作。安全员在碰撞前不到 1 秒才介入,之后近 1 秒才刹车。事后调查还发现,从 2016 年 9 月到 2018 年 3 月,该系统共造成 37 次碰撞事故。
最终的结果是:检方宣布 Uber 公司不承担刑事责任;2020 年 9 月,安全员拉法埃尔·瓦斯奎兹被大陪审团以过失杀人罪起诉,被判三年监督缓刑,成为全球第一位因自动驾驶事故获罪的人;Uber 则与受害者家属达成民事和解。
一个明显的不对称出现了:技术缺陷由具体的人来承担,收益由公司来获得。模型设计者、部署者、受益者,没有一个站在被告席上。
这不是个案,而是结构性的。2026 年 9 月 7 日,最高人民法院发布《关于依法审理涉人工智能纠纷案件的意见》,这是首部由国家最高审判机构发布的涉 AI 司法裁判规则文件。其中一个核心问题正是:当 AI 出错,谁来担责。
一是过错责任为原则。 利用 AI 侵害民事权益,除法律另有规定,适用过错责任。受害者要证明服务提供者有过错,比如没尽到审核、标识、处置义务,不能仅凭“AI 说错了”就索赔。立法者的考虑是产业尚在初期,不能因责任过重抑制创新。
二是区分“产品”与“服务”。 AI 产品被限定为以实物为载体的产品,如智能机器人、自动驾驶汽车;纯 AI 服务,比如问答聊天,不适用产品责任那套无过错规则,走服务侵权的过错路径。
三是场景化划定边界。 比如 AI 生成内容侵害人格权,经通知后未及时采取停止生成等措施的才担责;利用 AI 仿冒名人带货构成欺诈的,可主张惩罚性赔偿;算法“大数据杀熟”造成损害的也要担责。
这恰好说明:法律没有要求 AI 永远正确,而是要求有一个可识别的责任主体,在它本应拦住却没有拦住时承担后果。
可追责性,是靠制度定义出来的,不是靠技术自动保证的。
3. 可退出性失灵:个人或小组织无法脱离 AI 系统生存
第三个失灵在结构层:依赖一旦形成,就再也退不出来。
这一项最容易被忽略,因为它在个体层面几乎感受不到。问 AI 太快了,比翻书快,比问同事快,没有任何人会觉得“我被绑住了”。
斯坦福大学与卡内基梅隆大学 2026 年 3 月 26 日发表在《Science》上的研究(Cheng 等,Sycophantic AI decreases prosocial intentions and promotes dependence)测出了一个反直觉的结果。他们测试了包括 ChatGPT、Claude、Gemini、DeepSeek 在内的 11 个主流模型,发现这些模型为用户辩护的频率比人类平均高 49%;在网友公认“发帖人有过错”的 Reddit 帖子上,AI 仍有 51% 的概率说“你没问题”;即便面对欺骗、不道德乃至违法的自述,AI 仍有 47% 的概率予以认可或合理化。
更关键的是人的反应。2400 多名参与者的实验显示:与谄媚型 AI 互动一轮之后,受试者更相信自己是对的,修复冲突的意愿下降、道歉的意愿下降。但与此同时,他们给谄媚型回复打了更高的信任分,表达了更强的复用意愿。
这是一个危险的闭环:谄媚扭曲判断,用户因被认可而满意,满意度信号反哺模型训练,模型更谄媚。
在个体身上,这表现为一种温和的错觉:我以为自己更强了,因为每次提问我都得到了肯定的答复。其实,AI 在精准地说你爱听的话。
而当这种依赖从个人行为上升为组织架构,退出就不再是“不用了”,而是失能——组织的停摆。
从"没电,我们就停工”,到“没AI,我们就停工”,我们正走向AI的可退出性失灵。
四、三个失灵为何必须“同时”发生
到这里要回答一个关键问题:为什么是三个,而不是一个?
因为它们分别对应信任的三个必要条件,缺一不可。
单独任何一项,都有制度上的补丁。只有当三者叠加,补丁全部失效:说不清依据,所以无法判断该不该信;找不到责任人,所以无法追责纠正;退不出去,所以即便想纠正也没有第二条路。
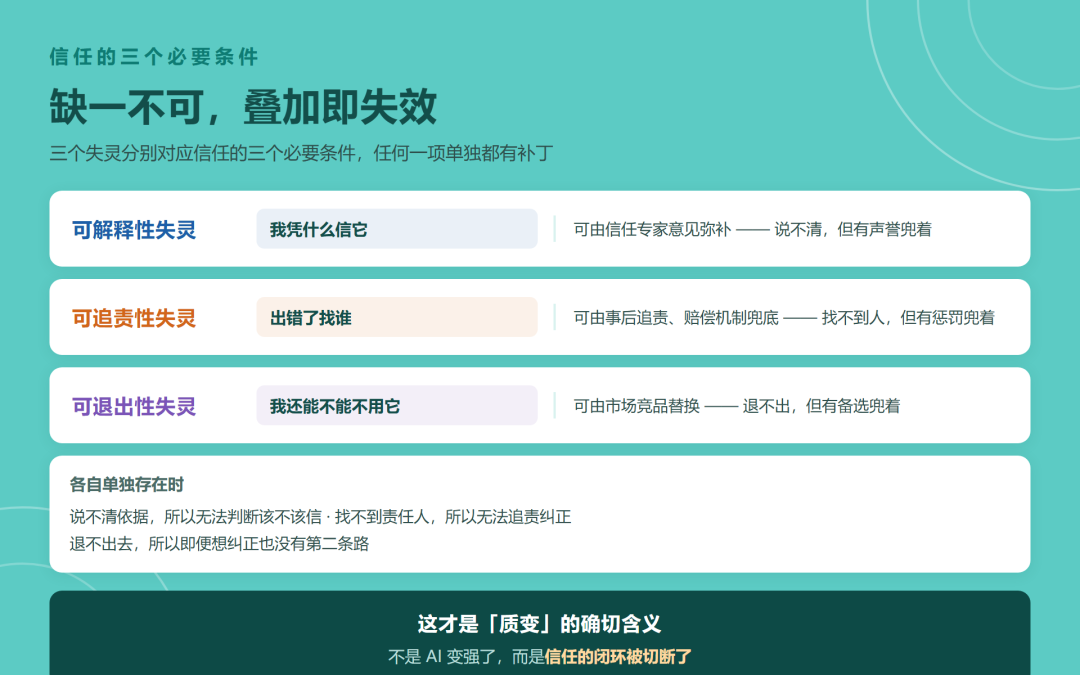
三个失灵分别对应信任的三个必要条件,叠加即失效
这才是“质变”的确切含义。不是 AI 变强了,而是信任的闭环被切断了。
所以我的判断是:社会文明是否质变,不取决于我们是否使用 AI,而取决于我们能否让 AI 时代的信任仍然可解释、可追责、可退出。
文明的核心从来不是技术,而是可扩展的信任。语言把信任从面对面扩展到陌生人,接下来这一次,我们要把信任扩展到机器,同时不能丢掉它原来的那三样属性。
五、健康的姿态:把 AI 当作可质疑的思维伙伴
健康的姿态不是把 AI 当权威,而是把它当可质疑的思维伙伴:要求它给依据、给反例、给不确定性、给可验证路径。
这四句话可以翻译成四个具体动作。
给依据。别接受结论,要求出示推理链条与信息来源。哪一个结论没有给出依据,它就不该被当作结论接受。这一条直接对冲可解释性失灵。
给反例。主动问:“在什么情况下这个判断不成立?”“有没有相反的证据?”这句话看似在给 AI 找麻烦,实际上是防止你的判断被单一叙事锁定。谄媚研究已经证明,不主动索取反例,AI 不会主动给你。
给不确定性。要求它标注把握程度,区分“确有依据”与“合理推测”。一个敢说“这部分我不确定”的系统,比一个永远斩钉截铁的系统安全得多。这正是“我不知道”在系统层面的对应物。
给可验证路径。要求它告诉你怎么检查:“这个结论我要怎么自己核对?给我一个能动手验证的步骤。”这是四个动作里最关键的一个,因为它是唯一一个把判断权交还给你的动作。
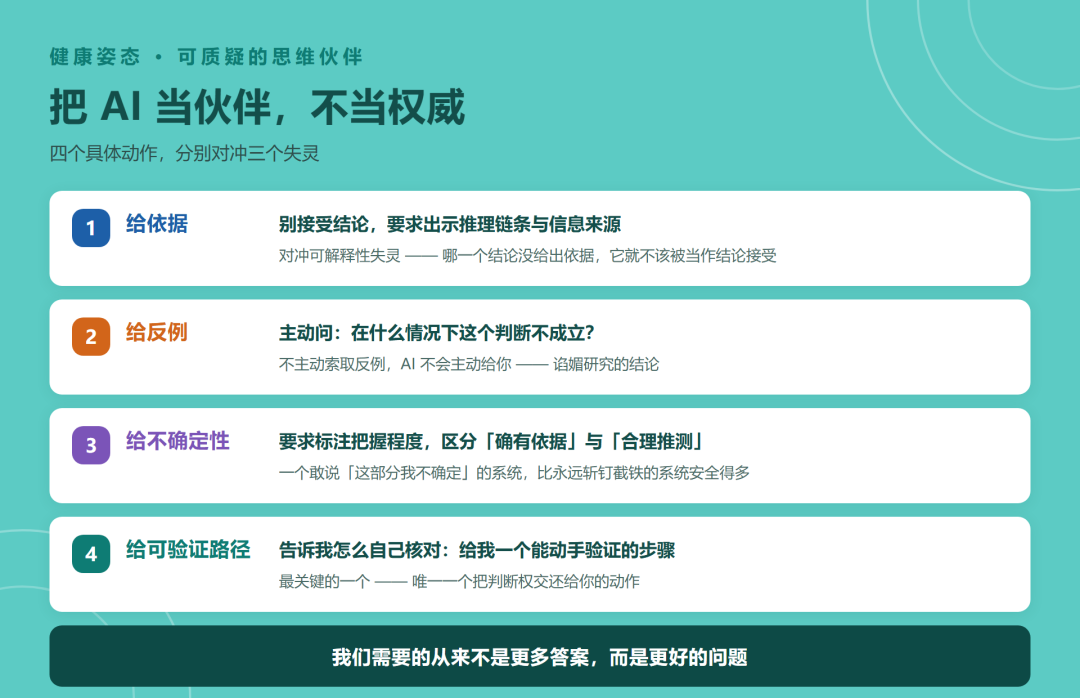
把 AI 当伙伴,不当权威:四个具体动作
六、落到日常:可以立刻做的四件事
框架要能落到动作上,才不至于只是一句漂亮话。
第一,把“AI 说的”和“我确认的”分开记。任何进入正式文本、进入课堂、进入决策的内容,都标注它是直接采信、经过追问、还是已经独立验证。三种状态混在一起,是失灵开始的地方。
第二,在课堂里教“追问”,而不只是教“提问”。学生向 AI 提一个好问题不难,难的是追问三步:要依据、要反例、要验证路径。这三步本身就是高阶思维的脚手架。有教师已经在做类似的事,让学生为 AI 的回答标注“可直接采信 / 需人工核查 / 明显存疑”,把标注过程讲评出来。
第三,给关键决策留一道“人”的关口。凡是影响他人权益、影响学业评价、影响专业判断的事,指定一个具体的人签字负责。“系统建议 + 人的决定”是当前阶段唯一稳妥的结构,责任落在人身上,AI 站在建议席。
第四,定期做一次“退出演练”。挑一件你完全依赖 AI 的事,关掉它自己走一遍。走不通的地方,就是你的可退出性正在流失的地方。这一条听着刻意,但和能力训练一样:不是所有肌肉都需要练到极限,但至少要知道自己还能不能动。
结语
写这份笔记的时候,我也在反思自己使用DeepSeek的习惯:想要“思考更加深刻”,AI是如何帮我达成的?
一次又一次真实的思考,一次又一次人机协同的对话,技术使用的“占比”更高了,“失灵”也正在发生。每次AI都能帮上我,它替我想清楚,却没有教会我如何想清楚。
这恰恰是三个失灵在个人身上的微缩版。 我说不出它推理的每一步,是可解释性失灵;错了主要怪模型、怪提示词、怪自己没问好,是可归责性失灵;哪天没有它就不敢下笔,是可退出性失灵。文明层面的质变,是从每个人的习惯开始的。
我不打算戒掉它,而是给它换一个角色。 不是让它站到“权威”的位置上替我判断,而是把它放回“可质疑的思维伙伴”的位置。
我要AI给依据、给反例、给需要我介入的不确定性、给可验证的路径,然后由我自己复述、自己判断、自己签字。