应用技巧 · 工作台 · 人机对话重构稿
Workbot应用技巧
——工作台搭建
从一次作业批改出发,把最小闭环做成可生长的工作台
整理自一次与DeepSeek关于工作台搭建的真实讨论 · 2026.11.11 · 全文约 4500 字
本文速览
① 第一版只做一件事:把“一次批改的核验闭环”跑通并归档。
② 界面可以极简,数据字段必须完整;否则扩展要推倒重来。
③ 核验分级 + 修改回写,让工作台下一轮比这一轮更准。
导语
很多人用 AI 的方式是“遇到一件事,开一个新对话”:提示词重写一遍,结果散在聊天记录里,下周再做同类工作,又从零开始。工作台要解决的正是这件事——不让每一次都从零开始。本文从一位教师的真实设想出发:先做一个只管“作业批改”的工作台,再谈扩展。我们把这次讨论里零散但准确的判断,整理成一套可以照着做、可以验证、可以回退的搭建方法。
目录
工作台不是软件里的一个功能菜单,也不是一次聊得不错的对话。它是一个可反复进入、产出可核验、结果可归档、过程可追溯、并且越用越准的工作单元。
它由四个部件组成:
三个常见误解值得先摆出来:
用一句话概括:工作台的价值不在于它能做多少事,而在于同一件事做第二遍时,比第一遍更省力、更准。
原始设想里有一句话很要紧:先把要面对的最核心问题搞清楚,也就是找准工作的痛点,无关紧要的事先不用去做。 这句话的实操含义比听起来更严格:
第一版的边界不是由“将来可能需要什么”决定的,而是由“哪一件事不做,这个工作台就没有存在理由”决定的。
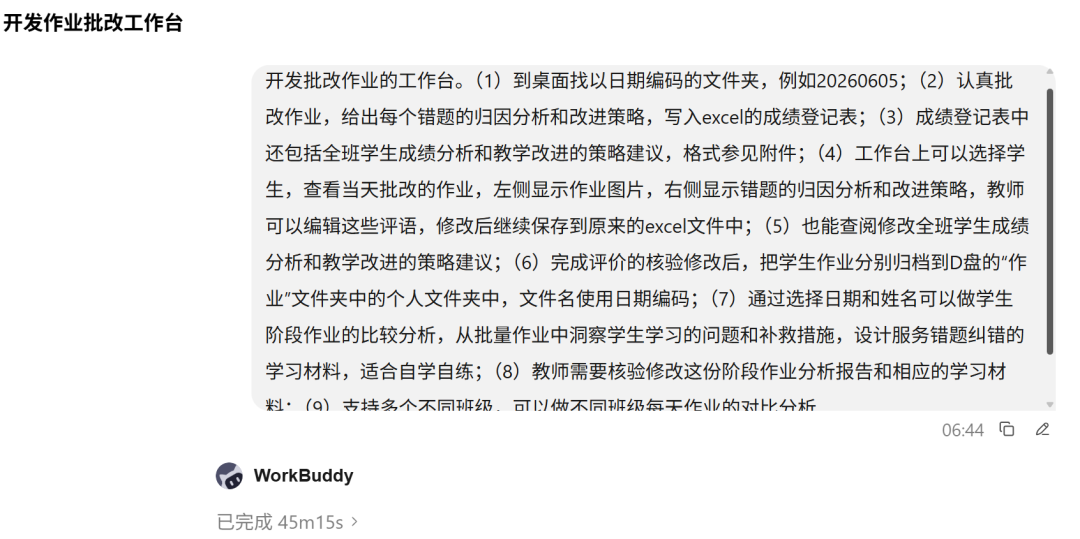
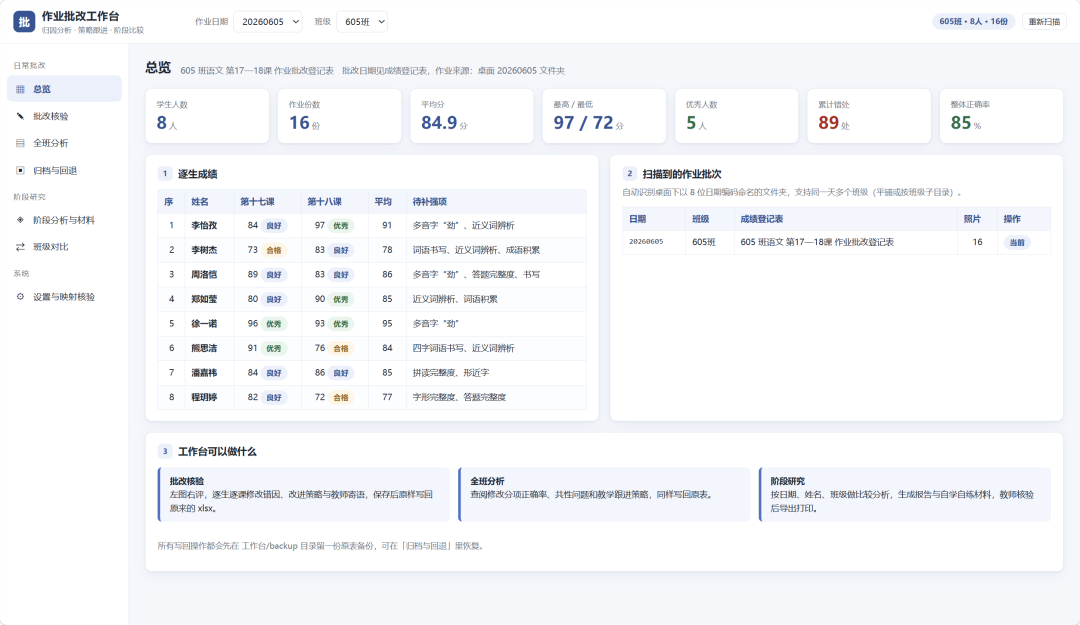
以作业批改为例,它的切口选得好,是因为起点和终点都清清楚楚:
●起点:作业数据进入工作台;
●终点:教师核验后的评语与分析报告归档落定;
●主链:作业批改 → 错题归因 → 生成含改进策略的评语 → 教师核验修改 → 全班学情分析与教学改进建议 → 教师核验修改 → 批改件与评语归档。
这条链之所以成立,是因为它闭合了一个可验证的循环:AI 产出 → 人做关键判断 → 结果落定。终点不是“AI 批完了”,而是“人确认过、并且归档了”。把终点定在核验之后,第一版就有了一个不可再简化的交付物:一份经过人确认、可追溯的批改记录。
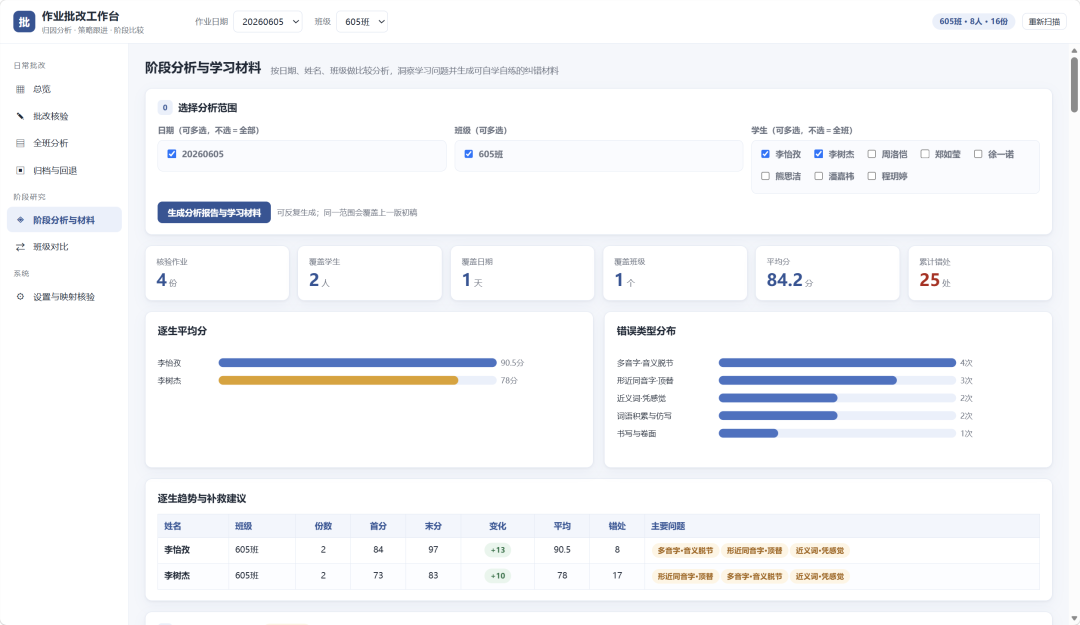
先跑通最小闭环,不等于以后不做别的。阶段性错题集、纠错学材、班级对比,都是在这个循环稳定之后,对同一批已归档数据的再聚合,而不是另起一条新链路。
下面七步按顺序做,每一步都有明确的产出物与验收口径。第一版只做第 1~6 步,第 7 步是让工作台“越用越准”的持续动作。
照着这句填:
当〔 〕进入工作台后,AI 产出〔 〕,教师核验〔 〕,最后把〔 〕归档到〔 〕,本次工作即告结束。
作业批改的填法:当本班本次作业数据进入后,AI 产出逐生评语与全班分析报告初稿,教师核验评语与教学改进建议,最后把批改件、评语终稿、报告终稿归档到已核验目录,本次工作即告结束。
验收:这句话里不出现“顺便”“以后还可以”“最好同时”等词。出现一次,就说明边界又被撬开了。
反面例子是“做一个教学全能助手”:三把筛子一把都过不了,因为它没有可判定的结束条件。切口越聚焦,后面的设计越稳定;场景一旦模糊,架构一定失控。
| 是 | |||
| 是 | |||
第一版的硬规则:只允许一条主链。 想加的第二条链路,先记在“v1 不做什么”里,等闭环稳定后再说。
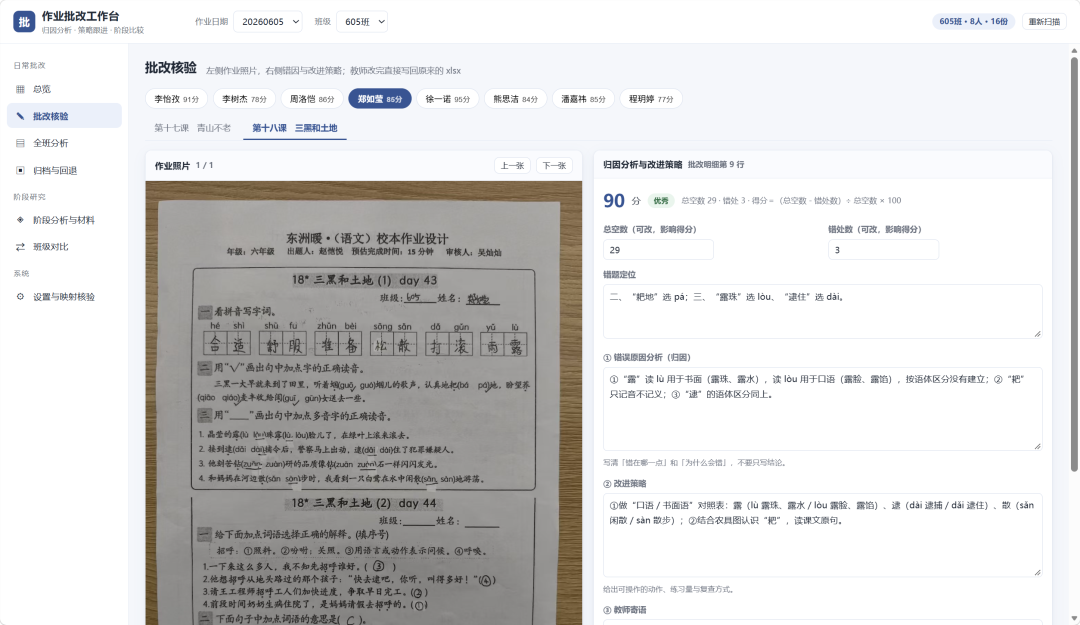
这是最容易被跳过、也最影响后续扩展的一步。作业批改最常见的错误,是把输出停留在“分数 + 一段评语”。分数和评语只能看,不能算;将来要做错题集、班级对比,就不得不回头重新解析自然语言。
真正让扩展成为可能的,是比分数更细的字段:
顺序不能反:先让 AI 产出这些结构化字段,再由字段生成评语;而不是先写一段漂亮评语,再从中反推错因。
验收:随机抽 5 条记录,12 项字段无缺失,且能直接按“知识点”分组汇总。
原始设想在评语和分析报告两处都安排了教师核验,这是对的;但两处的风险性质不同,不该用同一个“确认”按钮打发。
| 复核者 | ||||
| 兜底者 |
一句话:人机协同的关键不在于“加一个确认按钮”,而在于按风险分级设计人的角色。 低风险处追求顺滑,高风险处必须给足证据与决断入口。
核验完成不等于工作完成,落定才算。建议一个工作区里只放一个工作台目录,结构固定下来:
工作台/ └─ 作业批改/ ├─ 00_模板与规则/ 提示词模板、字段定义、归因规则、版本说明 ├─ 01_原始作业/ 待批改的输入文件 ├─ 02_AI初稿/ 评语初稿、分析初稿 ├─ 03_已核验/ 教师确认的终稿(唯一可信数据源) ├─ 04_归档报告/ 班级分析、教学改进建议终稿 ├─ 05_回写日志/ 修改前后对照与原因 └─ 99_历史版本/ v1、v2 … 改坏了能换回来命名规则:日期_班级_作业名_学号_版本,例如 20261111_八(3)_一次函数练习_07_v1.docx。
归档设计要预留四个聚合维度:按学生、按班级、按时间段、按知识点。只要第一版的记录在这四个维度上可检索,后续功能就是在同一底座上增加“视图”,而不是重建系统。99_历史版本 的用途很实在:模板、字段、归因规则每次改动前先存一份,任何一次改坏都能回退。
教师的每次修改都是高质量信号:它告诉系统 AI 在哪些错误类型上容易归因偏、在哪些知识点上判断不准。哪怕第一版只做一件事,也要把修改记下来,三列就够:
每周复盘一次,把高频修改转成两样东西:提示词的修订、归因规则的调整。人机协同的价值不只是“这一轮更准”,而是“下一轮因为人的修正而变得更准”。
迭代路线可以排得很克制:
这里有一条容易混淆的原则:“从最小功能做起”小的是用户可见的界面和交互,不是底层的数据模型。 扩展对第一版提出的真正要求,不是提前实现它们,而是提前让数据结构经得起它们将来的调用。两者并不矛盾。
上半圈 · 本轮更准
下半圈 · 下轮更准
两个半圈都转起来,工作台才会越用越准
把上面七步连起来看,工作台其实是一个上下两个半圈的循环:
●上半圈(本轮更准):AI 产出 → 人做关键判断 → 结果落定归档;
●下半圈(下轮更准):人的修改被记录 → 回写成规则或提示词 → 下一轮 AI 产出更贴近真实判断。
常见的断点有三种:
只做上半圈,得到的是一次好用的工具;上下两个半圈都转起来,得到的才是会生长的工作台。
不要凭感觉判断“搭好了”,拿一份真实作业跑一遍,逐项核对:
99_历史版本 |
规则很简单:任何一项不通过,先补这一项,不加新功能。 这份清单同时也是每周复盘时的体检表。
【名称】 【结束条件】当……进入,AI 产出……,人核验……,……归档,即告结束。 【v1 不做什么】……(把想加的第二条链路写在这里) 【唯一主链】①…… → ②…… → ③…… → ④…… → 归档 【数据字段】(至少含:群体 / 个体 / 知识点 / 错误类型 / 错误位置 / 修改前后 / 核验留痕 / 归档路径) 【核验分级】低风险=复核者(逐项确认);高风险=兜底者(证据呈现 + 采纳/驳回) 【归档规则】目录结构、命名规则、四个聚合维度、历史版本 【回写方式】AI 原判 | 教师改为 | 修改原因;每周复盘一次 【验收】七项清单全过才允许进入 v2 【v2 只加什么视图】……填完这九行,再打开工具动手。写不出来的那一行,就是下一轮要补的地方。
把这次讨论收成一句可操作的话:
第一版把“一次批改的核验闭环”做扎实,同时确保这次批改留下的数据,在未来按任何维度重新聚合时都不需要推倒重来。
做到这一点,后续的错题集、纠错学材、班级对比,都会变成同一底座上的自然生长,而不是一次又一次重新起炉灶。
今天不必搭完整套。只做一件事:拿最近一次真实作业,写出第 1 步那句结束条件,把第 2、3 步走完。窄闭环一旦跑通一次,工作台就已经成立了。
编者说明:本文根据一次关于“Work Buddy 的工作台如何建”的对话整理重构。原讨论提出了作业批改这一窄切口、批改—归因—评语—核验—归档的价值链,以及后续按学生阶段、班级对比扩展的设想,并提炼出单点闭环、人机分工、数据结构先行、视图式扩展、核验回写等判断。本文保留这些判断与案例,补齐了工作台定义、七步落地法、字段设计、核验分级、归档目录、实测验证清单与常见坑。文中所说的“工作台”指一套通用的工作方式,不依赖某个具体菜单或按钮。标题沿用原题写法 Workbot,正文统一使用官方名 WorkBuddy。
方法注:最小可用产品(先做减法)、人在回路、按风险分级设计复核者与兜底者角色、数据模型先行,均为工作台搭建的基本方法,本文只做教育场景的落地转译,不虚构具体数据来源与效果数字。